Reinforcement Learning for Real Life
About the workshop
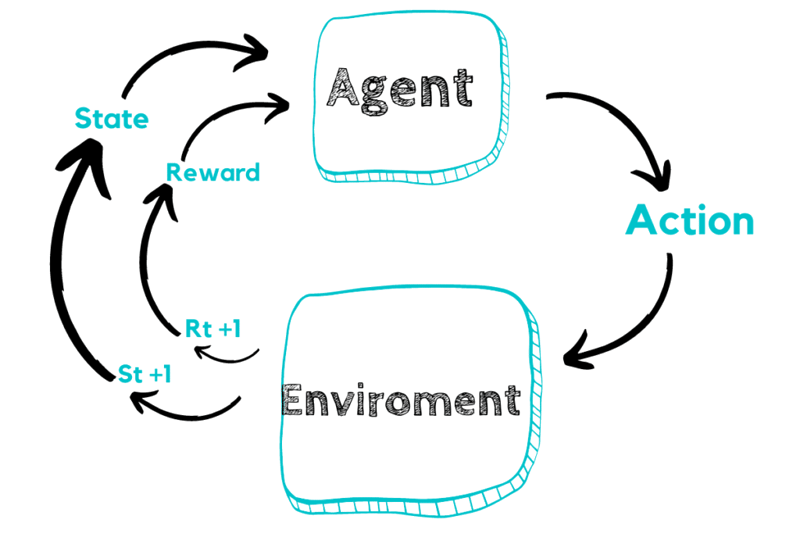
Reinforcement learning (RL) is a general learning, predicting, and decision making paradigm and applies broadly in many disciplines, including science, engineering and humanities. RL has seen prominent successes in many problems, such as Atari games, AlphaGo, robotics, recommender systems, and AutoML. However, applying RL in the real world remains challenging, and a natural question is:
Why isn’t RL used even more often and how can we improve this?
Schedule
- 9:00-11:00Poster Session
- 11:00-12:00RL Foundation PanelVideo ↗
- 12:00-13:00RL Explainability & Interpretability PanelVideo ↗
- 13:00-14:00RL + Robotics PanelVideo ↗
- 14:00-18:00Break
- 18:00-19:00RL + Recommender Systems PanelVideo ↗
- 19:00-20:00SpotlightVideo ↗
- 20:00-21:00RL Research-to-RealLife Gap PanelVideo ↗
- 21:00-22:00Break
- 22:00-23:00RL + OR PanelVideo ↗
- 23:00-1:00Poster Session
Panels
We will request invited panelists/moderators to share their expertise w.r.t. the real life aspects of RL by pre-recording videos. The moderators will host live panel discussions, and there will be polls for audience to submit questions.
RL Foundation Panel
RL Research-to-RealLife Gap Panel
RL + Robotics Panel
RL Explainability & Interpretability Panel
RL + Operations Research Panel
Accepted papers
The poster specs for ICML 2021 main conference: in .png format with a max size of 5120 x 2880, with an optional thumbnail image of size 320 x 256.
- DeepThermal: Combustion Optimization for Thermal Power Generating Units Using Offline Reinforcement LearningXianyuan Zhan (JD Intelligent Cities Research); Haoran Xu (Xidian University); Yue Zhang (JD Intelligent Cities Research); Xiangyu Zhu (JD Intelligent Cities Research); Honglei Yin (JD Intelligent Cities Research)
- Neural Rate Control for Video Encoding using Imitation LearningHongzi Mao (MIT CSAIL); Chenjie Gu (Deepmind); Miaosen Wang (Google); Angie Chen (Google); Nevena Lazic (DeepMind); Nir Levine (Deepmind); Derek Pang (Google); Rene Claus (Google); Marisabel Hechtman (Google); Ching-Han Chiang (Google Inc.); Cheng Chen (Google Inc.); Jingning Han (Google Inc.)
- Reinforcement Learning for (Mixed) Integer Programming: Smart Feasibility PumpMengxin Wang (University of California, Berkeley); Meng Qi (University of California, Berkeley); Zuo-Jun Shen (University of California, Berkeley)
- Continuous Doubly Constrained Batch Reinforcement LearningRasool Fakoor (Amazon); Jonas Mueller (AWS); Kavosh Asadi (Brown University); Pratik Chaudhari (University of Pennsylvania); Alex J Smola (Amazon)
- Contingency-Aware Influence Maximization: A Reinforcement Learning ApproachHaipeng Chen (Harvard University); Wei Qiu (Nanyang Technological University); Han-Ching Ou (Harvard University); Bo An (Nanyang Technological University); Milind Tambe (Harvard University)
- On the Difficulty of Generalizing Reinforcement Learning Framework for Combinatorial OptimizationMostafa Pashazadeh (University of Victoria); Kui Wu (University of Victoria)
- Doubly Robust Off-Policy Evaluation for Ranking Policies under the Cascade Behavior ModelHaruka Kiyohara (Tokyo Institute of Technology); Yuta Saito (Hanjuku-kaso, Co., Ltd.); Tatsuya Matsuhiro (Yahoo Japan Corporation); Yusuke Narita (Yale University); Nobuyuki Shimizu (Yahoo Japan Corporation); Yasuo Yamamoto (Yahoo! Japan)
- OffWorld Gym: Open-Access Physical Robotics Environment for Real-World Reinforcement Learning Benchmark and ResearchAshish Kumar (OffWorld Inc); Toby Buckley (Offworld Inc.); John Lanier (OffWorld, Inc.); Qiaozhi Wang (OffWorld, Inc.); Alicia Kavelaars (OffWorld Inc.); Ilya Kuzovkin (Offworld Inc.)
- Learning Barrier Certificates: Towards Safe Reinforcement Learning with Zero Training-time ViolationsYuping Luo (Princeton University); Tengyu Ma (Stanford)
- Automatic Risk Adaptation in Distributional Reinforcement LearningFrederik Schubert (Leibniz University Hannover); Theresa Eimer (Leibniz University Hannover); Bodo Rosenhahn (Leibniz University Hannover); Marius Lindauer (Leibniz University Hannover)
- Coordinate-wise Control Variates for Deep Policy GradientsYuanyi Zhong (University of Illinois at Urbana-Champaign); Yuan Zhou (UIUC); Jian Peng (University of Illinois at Urbana-Champaign)
- Disentangled Attention as Intrinsic Regularization for Bimanual Multi-Object ManipulationMinghao Zhang (Tsinghua University); Pingcheng Jian (Tsinghua University); Yi Wu (Tsinghua University); Huazhe Xu (UC Berkeley); Xiaolong Wang (UCSD)
- Learning Vision-Guided Quadrupedal Locomotion End-to-End with Cross-Modal TransformersRuihan Yang (UC San Diego); Minghao Zhang (Tsinghua University); Nicklas A Hansen (UC San Diego); Huazhe Xu (UC Berkeley); Xiaolong Wang (UCSD)
- Graph Neural Network Reinforcement Learning for Autonomous Mobility-on-Demand SystemsDaniele Gammelli (Technical University of Denmark (DTU)); Kaidi Yang (Stanford University); James Harrison (Stanford University); Filipe Rodrigues (Technical University of Denmark (DTU)); Francisco Pereira (DTU); Marco Pavone (Stanford University)
- Reward-Free Attacks in Multi-Agent Reinforcement LearningTed Fujimoto (Pacific Northwest National Laboratory); Timothy Doster (Pacific Northwest National Laboratory); Adam Attarian (PNNL); Jill M Brandenberger (PNNL); Nathan Hodas (Pacific Northwest National Lab)
- Evaluating the progress of Deep Reinforcement Learning in the real world: aligning domain-agnostic and domain-specific researchJuan Jose Garau Luis (MIT); Edward Crawley (MIT); Bruce Cameron (MIT)
- Corruption Robust Offline Reinforcement LearningXuezhou Zhang (UW-Madison); Yiding Chen (University of Wisconsin-Madison); Xiaojin Zhu (University of Wisconsin-Madison); Wen Sun (Cornell University)
- Deep Reinforcement Learning for 3D Furniture Layout in Indoor Graphic ScenesXINHAN DI (Deepearthgo); Pengqian Yu (Sea AI Lab)
- Learning to Represent State with Perceptual SchemataWilka Carvalho (University of Michigan); Murray P Shanahan (DeepMind Technologies Ltd)
- Continual Meta Policy Search for Sequential Multi-Task LearningGlen Berseth (University of California Berkeley); Zhiwei Zhang (Uc Berkeley)
- Reinforcement Learning as One Big Sequence Modeling ProblemMichael Janner (UC Berkeley); Qiyang Li (University of California, Berkeley); Sergey Levine (UC Berkeley)
- Of Moments and Matching: A Game-Theoretic Framework for Closing the Imitation GapGokul Swamy (Carnegie Mellon University); Sanjiban Choudhury (Aurora Innovation); J. Andrew Bagnell (Aurora Innovation); Steven Wu (Carnegie Mellon University)
- Learning Space Partitions for Path PlanningKevin Yang (UC Berkeley); Tianjun Zhang (UC Berkeley); Chris Cummins (Facebook AI Research); Brandon Cui (Facebook AI Research); Benoit Steiner (Facebook AI Research); linnan wang (brown); Joey Gonzalez (Berkeley); Dan Klein (University of California, Berkeley); Yuandong Tian (Facebook)
- ReLMM: Practical RL for Learning Mobile Manipulation Skills Using Only Onboard SensorsCharles J Sun (UC Berkeley); Jedrzej Orbik (UC Berkeley); Coline Devin (UC Berkeley); Abhishek Gupta (UC Berkeley); Glen Berseth (University of California Berkeley); Sergey Levine (UC Berkeley)
- Representation Learning for Out-of-distribution Generalization in Downstream TasksFrederik Träuble (MPI for Intelligent Systems); Andrea Dittadi (Technical University of Denmark); Manuel Wüthrich (MPI for Intelligent Systems); Felix Widmaier (MPI for Intelligent Systems, Tübingen); Peter Gehler (Amazon); Ole Winther (DTU and KU); Francesco Locatello (Amazon); Olivier Bachem (Google Brain); Bernhard Schölkopf (MPI for Intelligent Systems, Tübingen); Stefan Bauer (Max Planck institute)
- Symbolic Relational Deep Reinforcement Learning based on Graph Neural NetworksJaromír Janisch (Czech Technical University in Prague); Tomas Pevny (Czech Technical University in Prague); Viliam Lisy (Czech Technical University)
- Hierarchical Multiple-Instance Data Classification with Costly FeaturesJaromír Janisch (Czech Technical University in Prague); Tomas Pevny (Czech Technical University in Prague); Viliam Lisy (Czech Technical University)
- Multi-agent Deep Covering Option DiscoveryJiayu Chen (Purdue University); Marina W Haliem (Purdue University); Tian Lan (The George Washington University); Vaneet Aggarwal (Purdue University)
- Efficient Exploration by HyperDQN in Deep Reinforcement LearningZiniu Li (The Chinese University of Hong Kong, Shenzhen); Yingru Li (The Chinese University of Hong Kong, Shenzhen); Hao Liang (The Chinese University of Hongkong, Shenzhen); Tong Zhang (The Hong Kong University of Science and Technology)
- Revisiting Design Choices in Offline Model Based Reinforcement LearningCong Lu (University of Oxford); Philip J Ball (University of Oxford); Jack Parker-Holder (University of Oxford); Michael A. Osborne (University of Oxford); Stephen Roberts (Oxford)
- De novo drug design using reinforcement learning with graph-based deep generative modelsSara Romeo Atance (Chalmers University of Technology); Juan Viguera Diez (Chalmers University of Technology); Ola Engkvist (AstraZeneca AB); Simon Olsson (Chalmers University of Technology); Rocío Mercado (AstraZeneca)
- Optimization of high precision manufacturing by Monte Carlo Tree SearchDorina Weichert (Fraunhofer IAIS); Felix Horchler (Bonn University); Alexander Kister (Fraunhofer IAIS); Marcus Trost (Fraunhofer IOF); Johannes Hartung (Fraunhofer IOF); Stefan Risse (Fraunhofer IOF)
- Designing Online Advertisements via Bandit and Reinforcement LearningRichard Liu (Yale University); Yusuke Narita (Yale University); Kohei Yata (Yale University); Shota Yasui (Cyberagent)
- Semantic Tracklets: An Object-Centric Representation for Visual Multi-Agent Reinforcement LearningIou-Jen Liu (University of Illinois at Urbana-Champaign); Zhongzheng Ren (UIUC); Raymond A Yeh (UIUC); Alexander Schwing (UIUC)
- Model Selection for Offline Reinforcement Learning: Practical Considerations for Healthcare SettingsShengpu Tang (University of Michigan); Jenna Wiens (University of Michigan)
- Offline Reinforcement Learning as Anti-ExplorationShideh Rezaeifar (Geneva University); Robert Dadashi (Google); Nino Vieillard (Google Research); Léonard Hussenot (Google Research, Brain Team); Olivier Bachem (Google Brain); Olivier Pietquin (Google Research - Brain Team); Matthieu Geist (Google Brain)
- What Can I Do Here? Learning New Skills by Imagining Visual AffordancesKhazatsky Alexander (UC Berkeley); Ashvin V Nair (UC Berkeley)
- IV-RL: Leveraging Target Uncertainty Estimation for Sample Efficiency in Deep Reinforcement LearningVincent Mai (Mila, Université de Montréal); Kaustubh Mani (Mila, Université de Montréal); Liam Paull (Université de Montréal)
- Learning a Markov Model for Evaluating Soccer Decision MakingMaaike Van Roy (KULeuven); Pieter Robberechts (KU Leuven); Wen-Chi Yang (KU Leuven); Luc De Raedt (KU Leuven); Jesse Davis (KU Leuven)
- Topological Experience Replay for Fast Q-LearningZhang-Wei Hong (Massachusetts Institute of Technology); Tao Chen (MIT); Yen-Chen Lin (MIT); Joni Pajarinen (Aalto University); Pulkit Agrawal (MIT)
- AppBuddy: Learning to Accomplish Tasks in Mobile Apps via Reinforcement LearningMaayan Shvo (University of Toronto and Vector Institute); Zhiming Hu (Samsung AI Center, Toronto); Rodrigo A Toro Icarte (University of Toronto and Vector Institute); Iqbal Mohomed (Samsung Research America); Allan D Jepson (Samsung Toronto AIC); Sheila A. McIlraith (University of Toronto and Vector Institute)
- Reward Shaping for User Satisfaction in a REINFORCE RecommenderKonstantina Christakopoulou (Google); Can Xu (Google); Sai Zhang (Google); Sriraj Badam (Google); Trevor Potter (Google); Daniel Li (Google); Hao Wan (Google); Xinyang Yi (Google); Ya Le (Google); Chris Berg (Google); Eric Bencomo Dixon (Google); Ed H. Chi (Google); Minmin Chen (Google)
- Learning Action Translator for Meta Reinforcement Learning on Sparse-Reward TasksYijie Guo (University of Michigan); Qiucheng Wu (University of Michigan); Honglak Lee (LG AI Research / University of Michigan)
- Mind the Gap: Safely Bridging Offline and Online Reinforcement LearningWanqiao Xu (University of Michigan); Kan Xu (University of Pennsylvania); Hamsa Bastani (Wharton); Osbert Bastani (University of Pennsylvania)
- Deploying a Machine Learning System for COVID-19 Testing in GreeceHamsa Bastani (Wharton); Kimon Drakopoulos (USC, Data Sciences and Operations); Vishal Gupta ()
- The Reflective Explorer: Online Meta-Exploration from Offline Data in Visual Tasks with Sparse RewardsRafael Rafailov (Stanford University); Varun Kumar (Intel AI Lab); Tianhe Yu (Stanford University); Avi Singh (UC Berkeley); Mariano Phielipp (Intel AI Lab); Chelsea Finn (Stanford)
- Improving Human Decision-Making with Machine LearningHamsa Bastani (Wharton); Osbert Bastani (University of Pennsylvania); Wichinpong Sinchaisri (Berkeley Haas)
- Avoiding Overfitting to the Importance Weights in Offline Policy OptimizationYao Liu (Stanford University); Emma Brunskill (Stanford University)
- Towards Reinforcement Learning for Pivot-based Neural Machine Translation with Non-autoregressive TransformerEvgeniia Tokarchuk (University of Amsterdam); Jan Rosendahl (RWTH Aachen University); Weiyue Wang (RWTH Aachen University); Pavel Petrushkov (eBay); Tomer Lancewicki (eBay Research); Shahram Khadivi (eBay, Inc.); Hermann Ney ( RWTH Aachen University)
- Data-Pooling Reinforcement Learning for Personalized Healthcare InterventionXinyun Chen (Chinese University of Hong Kong, Shenzhen); Pengyi Shi (Purdue University); Xiuwen Wang (Chinese University of Hong Kong, Shenzhen)
- Mitigating Covariate Shift in Imitation Learning via Offline Data Without Great CoverageJonathan Chang (Cornell University); Masatoshi Uehara (Cornell University); Dhruv Sreenivas (Cornell University); Rahul Kidambi (Amazon Search & AI); Wen Sun (Cornell University)
- MobILE: Model-Based Imitation Learning From Observation AloneRahul Kidambi (Amazon Search & AI); Jonathan Chang (Cornell University); Wen Sun (Cornell University)
- Objective Robustness in Deep Reinforcement LearningJack Koch (Unaffiliated); Lauro Langosco di Langosco (ETH); Jacob Pfau (University of California San Francisco); James Le (Unaffiliated); Lee D Sharkey (ETHZ)
- Is Bang-Bang Control All You Need?Tim N Seyde (MIT); Igor Gilitschenski (Massachusetts Institute of Technology); Wilko Schwarting (Massachusetts Institute of Technology); Bartolomeo Stellato (Princeton University); Martin Riedmiller (DeepMind); Markus Wulfmeier (DeepMind); Daniela Rus (MIT CSAIL)
- Off-Policy Evaluation with General Logging PoliciesKyohei Okumura (Northwestern University); Yusuke Narita (Yale University); Kohei Yata (Yale University); Akihiro Shimizu (Mercari)
- Safe Deep Reinforcement Learning for Multi-Agent Systems with Continuous Action SpacesZiyad Sheebaelhamd (ETH Zurich); Konstantinos Zisis (ETH Zurich); Athina Nisioti (ETH Zurich); Dimitris Gkouletsos (ETH Zurich); Dario Pavllo (ETH Zurich); Jonas Kohler (ETHZ)
- Reinforcement Learning with Logical Action-Aware Features for Polymer DiscoverySarathkrishna Swaminathan (IBM Research); Dmitry Zubarev (IBM Research-Almaden); Subhajit Chaudhury (IBM Research AI); Asim Munawar (IBM Research)
- Constraints Penalized Q-Learning for Safe Offline Reinforcement LearningHaoran Xu (Xidian University); Xianyuan Zhan (JD Intelligent Cities Research); Xiangyu Zhu (JD Intelligent Cities Research)
- ModelLight: Model-Based Meta-Reinforcement Learning for Traffic Signal ControlXingshuai Huang (McGill University); di wu (McGill); Benoit Boulet (Benoit Boulet, McGill University)
- Robust Risk-Sensitive Reinforcement Learning Agents for Trading MarketsYue Gao (University of Alberta); Pablo Hernandez-Leal (Borealis AI); Kry Yik Chau Lui ()
- Reinforcement Learning for Power System Control: Using Adversarial Training to Improve RobustnessAlexander Pan (Caltech); Yongkyun Lee (Caltech); Yuanyuan Shi (Caltech); Huan Zhang (UCLA)
- Understanding the Generalization Gap in Visual Reinforcement LearningAnurag Ajay (MIT); Ge Yang (University of Chicago); Ofir Nachum (Google); Pulkit Agrawal (MIT)
- Optimizing Dynamic Treatment Regimes via Volatile Contextual Gaussian Process BanditsAhmet Alparslan Celik (Bilkent University); Cem Tekin (Bilkent University)
- Reset-Free Reinforcement Learning via Multi-Task Learning: Learning Dexterous Manipulation Behaviors without Human InterventionAbhishek Gupta (UC Berkeley); Justin Yu (Berkeley); Zihao Zhao (UC Berkeley); Vikash Kumar (Univ. of Washington); Aaron Rovinsky (UC Berkeley); Kelvin Xu (University of California, Berkeley); Thomas Devlin (UC Berkeley); Sergey Levine (University of California, Berkeley)
- Attend2Pack: Bin Packing through Deep Reinforcement Learning with AttentionJingwei Zhang (University of Freiburg); Bin Zi (Dorabot Inc.); Xiaoyu Ge (Australian National University)
- Designing Interpretable Approximations to Deep Reinforcement LearningNathan J Dahlin (University of Southern California); Krishna C Kalagarla (University of Southern California); Nikhil Naik (University of Southern California); Rahul Jain (University of Southern California); Pierluigi Nuzzo (University of Southern California)
- Decision Transformer: Reinforcement Learning via Sequence ModelingLili Chen (UC Berkeley); Kevin Lu (UC Berkeley); Aravind Rajeswaran (University of Washington); Kimin Lee (UC Berkeley); Aditya Grover (Facebook AI Research); Michael Laskin (UC Berkeley); Pieter Abbeel (UC Berkeley); Aravind Srinivas (UC Berkeley); Igor Mordatch (Google)
- Multi-Task Offline Reinforcement Learning with Conservative Data SharingTianhe Yu (Stanford University); Aviral Kumar (UC Berkeley); Yevgen Chebotar (Google); Karol Hausman (Google Brain); Sergey Levine (UC Berkeley); Chelsea Finn (Stanford)
- Value-Based Deep Reinforcement Learning Requires Explicit RegularizationAviral Kumar (UC Berkeley); Rishabh Agarwal (Google Research, Brain Team); Aaron Courville (University of Montreal); Tengyu Ma (Stanford); George Tucker (Google Brain); Sergey Levine (UC Berkeley)
- A Policy Efficient Reduction Approach to Convex Constrained Deep Reinforcement LearningTianchi Cai (Ant Group); Wenpeng Zhang (Ant Group); Lihong Gu (Ant Group); Xiaodong Zeng (Ant Services Group); Jinjie Gu (Ant Group)
- Hierarchical Imitation Learning with Contextual Bandits for DynamicTreatment RegimesLu Wang (East China Normal University); Wenchao Yu (UCLA); Wei Cheng (NEC); Bo Zong (NEC); Haifeng Chen (NEC)
- Reinforcement Learning Agent Training with Goals for Real World TasksXuan Zhao (Microsoft); Marcos Campos (microsoft)
- RRL: Resnet as representation for Reinforcement LearningRutav M Shah (Indian Institute of Technology, Kharagpur); Vikash Kumar (Univ. of Washington)
Call for papers
Reinforcement learning (RL) is a general learning, predicting, and decision making paradigm and applies broadly in many disciplines, including science, engineering and humanities. RL has seen prominent successes in many problems, such as Atari games, AlphaGo, robotics, recommender systems, and AutoML. However, applying RL in the real world remains challenging, and a natural question is:
Why isn’t RL used even more often and how can we improve this?
The main goals of the workshop are to: (1) identify key research problems that are critical for the success of real-world applications; (2) report progress on addressing these critical issues; and (3) have practitioners share their success stories of applying RL to real-world problems, and the insights gained from such applications.
We invite paper submissions successfully applying RL algorithms to real-life problems and/or addressing practically relevant RL issues. Our topics of interest are general, including (but not limited to):
Practical RL algorithms, which cover all algorithmic challenges of RL, especially those that directly address challenges faced by real-world applications;
Practical issues: generalization, sample/time/space efficiency, exploration vs. exploitation, reward specification and shaping, scalability, model-based learning (model validation and model error estimation), prior knowledge, safety, accountability, interpretability, reproducibility, hyper-parameter tuning;
Applications: advertizing, autonomous driving, business processes, chemical synthesis, conversational AI, drawing, drug design, education, energy, finance, healthcare, industrial control, music, recommender systems, robotics, transportation, or other problems in science, engineering and humanities.
We invite unpublished submissions up to 8 pages excluding references and appendix, in PDF format using the ICML 2021 template and style guidelines. Here is a customized style file for the workshop. (In the .tex file, use "\usepackage{icml2021}" for the submission, and use "\usepackage[accepted]{icml2021}" for the final version if accepted.) We welcome position papers and are open to papers currently under review at other venues. We will follow a double-blind review. We also welcome recently published work, which may keep its original format (for submission and for final version). For the submissions of ICML rejections, please attach the reviews. All accepted papers will be presented as posters, and will be made available on the workshop website. Accepted papers are non-archival, i.e., there will be no proceedings for this workshop.
The submission website is: https://cmt3.research.microsoft.com/RL4RealLife2021/
Organizers